

- Published on
NVIDIA 发布 CUDA Rust:用 Rust 编写 GPU 内核的两条路径
- Authors
- Name
- nonmaskable
- developer.nvidia.com
背景与动机
2026 年 9 月,NVIDIA 宣布正式支持在 Rust 中编写原生 GPU 内核,推出了两个开源项目:cuda-oxide 和 cutile-rs。AI 系统层(推理引擎、服务基础设施、驱动等)越来越多地使用 Rust 编写,因其在编译时捕获大量错误且不牺牲性能。之前 GPU 内核需用其他语言编写,CUDA Rust 填补了这一空白。
SIMT 路径:cuda-oxide
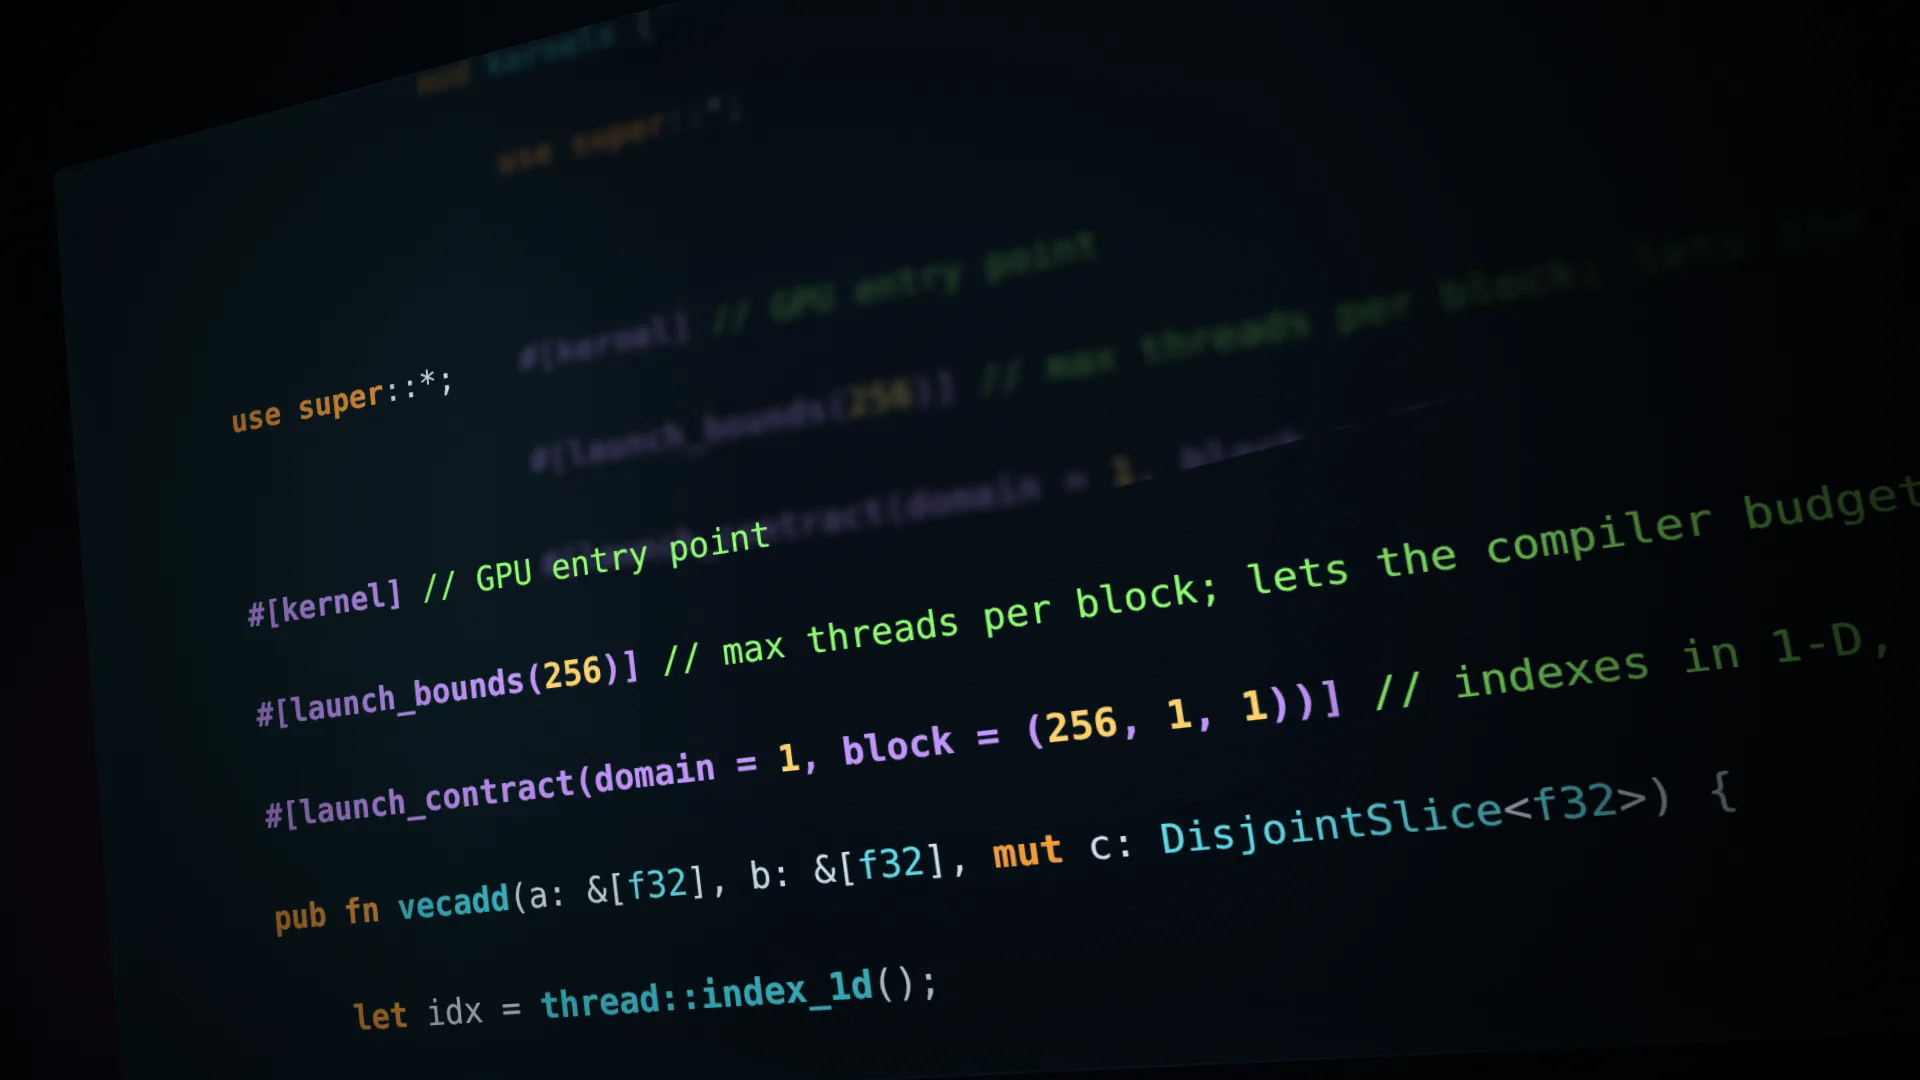
cuda-oxide 是一个自定义 rustc 代码生成后端,将标记为 #[kernel] 的函数通过 Rust MIR、Pliron IR 框架和 LLVM IR 最终编译为 PTX。它采用 SIMT(单指令多线程)模型,开发者描述单个线程的行为,并启动数千个线程。
安全设计
- 内存安全:使用
DisjointSlice类型确保每个线程只能访问自己的元素,避免别名。thread::index_1d()返回索引类型而非裸整数,c.get_mut(idx)返回Option防止越界。 - 启动契约:通过
#[launch_contract]声明内核的索引维度和块大小,prepare_vecadd在运行时验证配置,返回一个证明令牌,安全方法vecadd要求该令牌,避免未经验证的启动。
系统要求与使用
- 需要 Linux、计算能力 8.0+ 的 GPU、CUDA 12.x+、clang 及 libclang 头文件、指定的 nightly 工具链。
- 使用
cargo oxide子命令脚手架并运行,示例展示了完整的向量加法程序:主机和设备代码在同一文件中,一行命令构建并运行,输出 "PASSED: all 1024 elements correct"。
Tile 路径:cutile-rs
cutile-rs 采用更高级的 Tile 模型,开发者描述单个数据块的操作,编译器决定线程映射和内存布局。它通过 #[cutile::module] 宏将内核的 AST 嵌入主机二进制,首次启动时通过 CUDA Tile IR 进行 JIT 编译。
轻量级依赖
- 仅需计算能力 8.0+ 的 GPU、CUDA 13.3、稳定 Rust 1.89+ 和 Linux,无需 nightly 或自定义 LLVM。
- 已发布在 crates.io,可直接
cargo add cutile使用。
安全与易用性
- 分区机制:对于可写张量,主机端使用
.partition([B])将数据划分为互斥的子张量,每个 Tile 块获得唯一个子张量的&mut,保证独占性。 - 输入张量使用
-1表示动态维度,在启动时解析,避免重新编译。 - 示例中,分区、启动、同步全部通过方法链完成,最终输出
PASSED: all 1024 elements correct。
未来计划
NVIDIA 计划支持 CUDA Rust、CUDA C++ 和 CUDA Python 之间的互操作性,确保前端选择不会锁定开发者。cuda-oxide 仍处于早期 alpha 阶段,cutile-rs 已应用于 HuggingFace 的 Grout 推理引擎和 mistral.rs 等项目中。社区可通过 Discord 和 GitHub Discussions 参与反馈。
原标题:Nvidia announces native GPU programming in Rust。 HN 原始发布时间:2026年9月16日星期三。当前记录为 930 分、385 条评论。