

- Published on
AI爬虫的沉重负担:git.kernel.org的困境
- Authors
- Name
- zdw
- people.kernel.org
背景:AI爬虫为何盯上Linux内核仓库
Linux内核开发完全在公开环境下进行,包括可克隆的Git仓库和实时可追踪的讨论存档。对大型语言模型(LLM)而言,这些数据是极具价值的训练素材,因为它们不仅容易获取,还能保证内容纯净、未经AI污染。训练LLM使用由LLM生成的内容会引发类似“数字朊病毒病”的问题,因此像内核提交历史这样保证无AI参与的数据源,在训练数据中价值极高。然而,AI公司却选择了最愚蠢的方式来获取这些数据:不是直接克隆仓库,而是通过逐提交渲染为HTML再解析。例如,linux.git仓库约有148万次提交,而git.kernel.org上存在922个该仓库的分支。虽然后端因共享对象而效率较高,但对爬虫而言,这意味着有数十亿个有效URL可供抓取,且最终获得的只是相同148万次提交的922份重复副本。更糟糕的是,除了提交本身,系统还能生成任意提交间的补丁、渲染、差异等页面,仅单个分支就能产生约1.2兆个有效URL。
问题:系统负载的“背景辐射”与爬虫策略演变
最初,管理员通过日志识别爬虫的User-Agent并封禁IP,但爬虫很快伪装成普通浏览器。随后,封禁IP也失效,因为爬虫会从整个子网发起攻击,例如来自Google Compute的IP伪装成Firefox用户。更糟糕的是,爬虫开始利用数百万随机住宅或移动IP地址,每个IP仅发4-5个请求后就消失,使得封禁毫无意义,只会徒增防火墙规则。这些爬虫像蝗虫一样蜂拥而至,快速冲击系统直至其崩溃,然后转向下一个目标,待系统恢复后再返回。这种模式持续至今,其背后是“代理SDK变现”的巨大产业,甚至用户的电视机都可能参与其中。
解决方案的尝试与失败:Anubis的攻防战
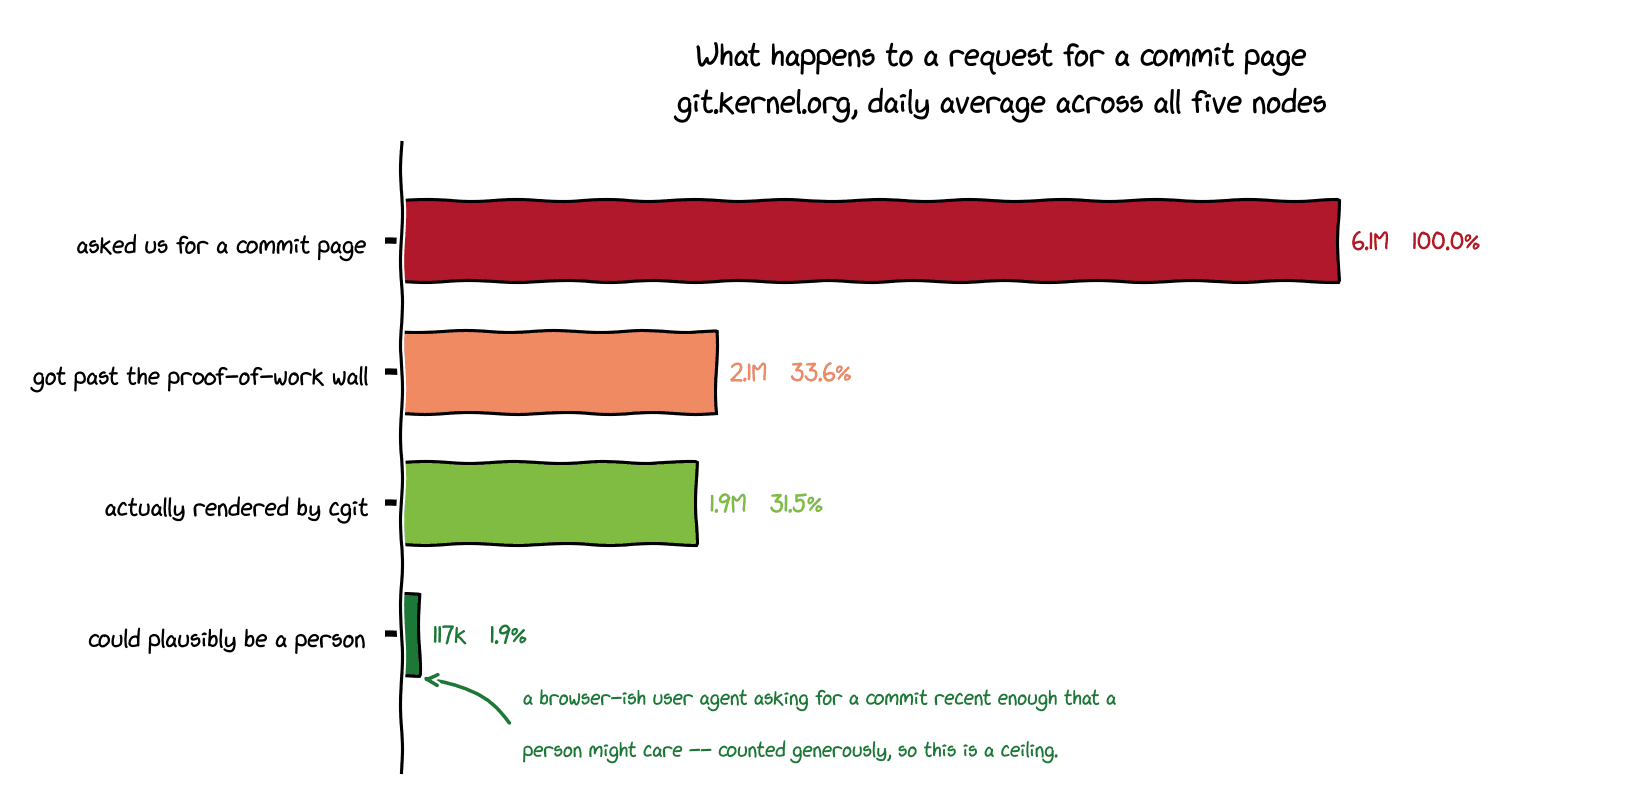
大约一年前,管理员部署了Anubis工作量证明挑战,要求客户端计算一个与自身IP和服务器提供的秘密组合后,能生成sha256前缀零的字符串。初期效果显著,爬虫放弃攻击。但几个月后,爬虫解决了难度4的挑战;管理员将难度提升至5,合法用户(尤其是移动设备)需要数秒才能完成计算,且手机发热,但爬虫再次突破。目前,git.kernel.org每天收到约600万次请求,其中66%被Anubis立即拦截,但33%成功通过——因为爬虫愿意花费大量计算资源来获取数据。管理员无法准确区分通过挑战的是爬虫还是真实用户,但请求老旧分支中旧提交的几乎都是爬虫。估算显示,合法请求仅占总流量的约2%。
影响:20%的CPU核心被浪费
在5个地理分布节点共90个核心中,有14-16个核心持续用于为爬虫渲染提交,平均占用20%的容量。实际负载更为波动,爬虫浪潮会导致负载尖峰。尽管网站目前仍能保持响应迅速,但管理员被迫关闭部分功能以减少可爬取URL数量,并限制匿名访问。这虽然会降低用户体验,但在当前情况下已成为必要措施。管理员承诺仍会提供所有数据的下载,但用户可能需要通过更多验证才能获取。
未来展望
管理员对未来形势并不确定。可能AI泡沫破裂后爬虫减少,或者AI公司改用更高效的数据获取方式。但目前,随着提供定制AI模型的公司不断涌现,对训练数据的需求持续增长,而应用开发者为了盈利,可能会继续将用户的家用设备变为攻击向量。管理员只能不断加高门槛,并关闭部分功能以降低消耗。他们强调,自己同样讨厌这种做法,但别无选择。这种困境没有简单解决方案,系统维护者只能持续与爬虫进行技术对抗。从这个案例可以看出,AI技术的发展带来了数据获取方式的野蛮生长,对开源基础设施造成了严重负担。未来,可能需要更完善的行业规范或技术标准,才能平衡AI训练需求与资源提供者之间的利益。
原标题:Creepy Crawlies。 HN 原始发布时间:2026年8月30日星期日。当前记录为 961 分、468 条评论。