

- Published on
Qwen 3.8 27B:本地大模型的性能与过度思考问题
- Authors
- Name
- bilsbie
- simonwillison.net
模型发布与概况
阿里巴巴Qwen研究实验室于2026年8月14日发布了Qwen 3.8 27B模型。这是一个27B参数、支持视觉能力的大语言模型,采用Apache 2开源许可证。27B参数规模非常适合在配置合理的笔记本电脑上运行,其前代产品Qwen 3.6 27B已表现出色。
Qwen官方自报的基准测试结果令人瞩目,显示该模型相比Qwen 3.6 27B以及今年5月仍是最强模型之一的闭源模型Qwen 3.7-Plus均有显著提升。独立基准测试的结果值得期待。
作者在128GB M5 Max MacBook Pro和NVIDIA DGX Spark两台机器上运行了该模型,均使用LM Studio及其17GB的Q4_K_M量化版本,也在Spark上直接尝试了llama-server。
默认极高推理深度导致过度思考
Qwen文档描述该模型默认使用xhigh推理深度,LM Studio的GGUF版本也保留了这一默认设置。官方提供了三种推理深度选项:
- xhigh(默认):适用于需要深入分析的复杂任务
- medium:平衡准确性和速度
- low:高效推理,优化速度和成本
作者认为这是一个“滑稽”的默认设置,绝非运行模型的好方式,尤其是在消费级硬件上。测试中,LM Studio默认的8192 token上下文限制很快被用尽——Qwen连最平凡的问题都要用光所有token来思考。将上下文长度加载到完整的262144 token后,问题才得以解决。
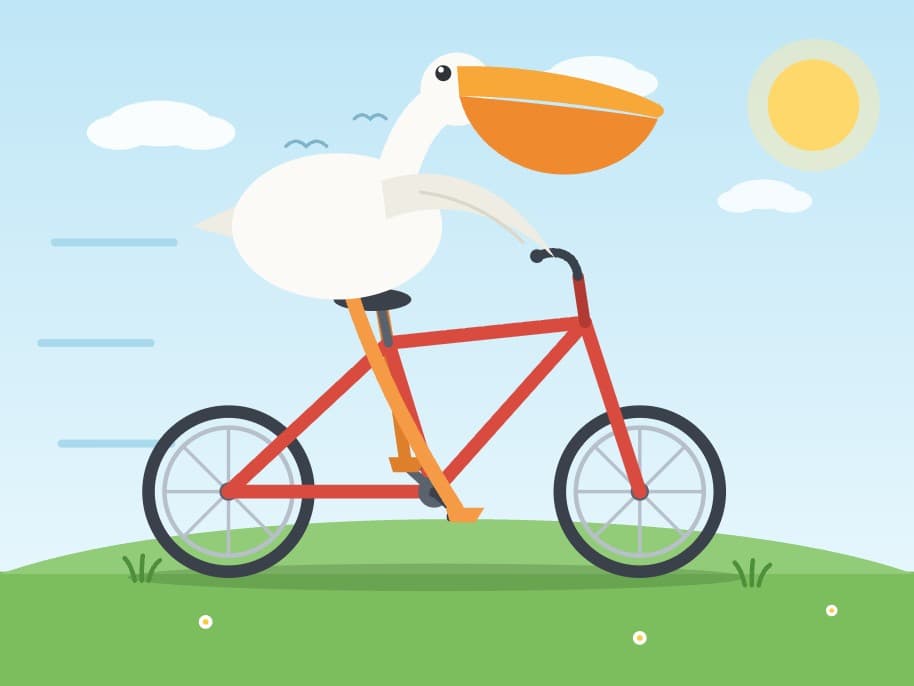
作者首次尝试用增加后的上下文长度生成“骑自行车的鹈鹕”SVG图像,耗时21分钟,使用了22276个推理token生成3223个输出token。虽然这是作者在本地机器上生成过的最好的鹈鹕SVG,但等待21分钟显然不值得。关闭推理后,同一提示仅用137秒就生成了3715个token。
更极端的例子是,用默认极高推理深度提示“画一个圆的SVG”,模型竟然生成了一个精美的动画圆,完全偏离了用户要求。
边界框标注能力出色
测试视觉模型的一个有趣方式是看它如何返回照片中物体的边界框。作者用iNaturalist上的一张鹈鹕照片进行测试,要求模型以0-1000比例返回JSON格式的边界框。模型成功返回了两个精确匹配的边界框坐标。
作者还让Qwen 3.8 27B构建了一个可视化边界框的工具。尽管忘记调低推理深度导致工具被过度设计,但模型仅凭一个提示就生成了完整界面,甚至自作主张添加了示例场景——用画布绘制了鹈鹕剪影来演示缩放功能。关闭推理后,模型生成的工具虽然接近可用,但边界框位置有误,说明推理能力确实能带来差异。
编码代理能力
本地模型能否成功运行编码代理循环是重要问题。编码代理需要长上下文、强大的代码生成支持和可靠的工具调用能力。Qwen 3.8 27B理论上具备这三者。
作者用Pi代理进行了初步实验,配置Pi使用LM Studio上运行的Qwen 3.8 27B。在Datasette文件夹中询问“认证如何工作?”后,模型通过一系列推理和工具调用访问了多个文件,给出了非常扎实的回答。随后又让模型将JSONL对话记录转换为Markdown,模型成功构建并测试了转换脚本。
性能瓶颈与加速探索
尽管模型功能强大,但速度是主要短板。即使在无推理深度下,LM Studio每秒仅能生成15-30个token,远不如托管API模型。
好消息是社区已探索出加速方案。Qwen支持多令牌预测(Multi-Token Prediction)架构技巧,通过廉价机制猜测多个后续令牌,再由主模型快速验证。作者在DGX Spark上使用llama.cpp的MTP功能运行模型,获得了约72%的性能提升。预计未来几周会有更多创新方案出现。
总结与展望
一个17GB的文件能在家庭机器上完成所有这些工作堪称奇迹。一年前这还足以与最昂贵专有模型竞争,如今已能在高性能笔记本上运行。
唯一阻碍其成为日常工具的是性能。在M5 Mac和DGX Spark上都感觉较慢,这是密集模型(非混合专家模型)的固有问题——需要大量内存带宽。但考虑到模型的能力和开源特性,以及社区正在探索的加速方案,Qwen 3.8 27B的前景非常光明。
原标题:Qwen 3.8 27B is excellent, but it defaults to overthinking things。 HN 原始发布时间:2026年8月17日星期一。当前记录为 751 分、360 条评论。