

- Published on
Astra 能直接读写神经网络权重:从游戏策略到提升 Qwen 数学能力
- Authors
- Name
- dbreunig
- rikiyat.github.io
核心发现
本文介绍了一项来自 MIT CSAIL 的研究,展示了当前前沿大语言模型(文中以 GPT-6 Astra 为例)在原生读写神经网络权重方面的惊人能力。作者将这一范式称为“权重空间编程”(Weight-Space Programming),即大语言模型直接读取和修改神经网络的原始权重,而非通过梯度下降或传统优化器,从而理解、修复乃至从零编写神经网络。研究结果覆盖了小规模游戏策略网络、扩散模型、字符级语言模型,以及真实的大语言模型 Qwen3.5-0.8B,显示了这一方法在优化与可解释性方面的巨大潜力。
实验一:从权重识别游戏
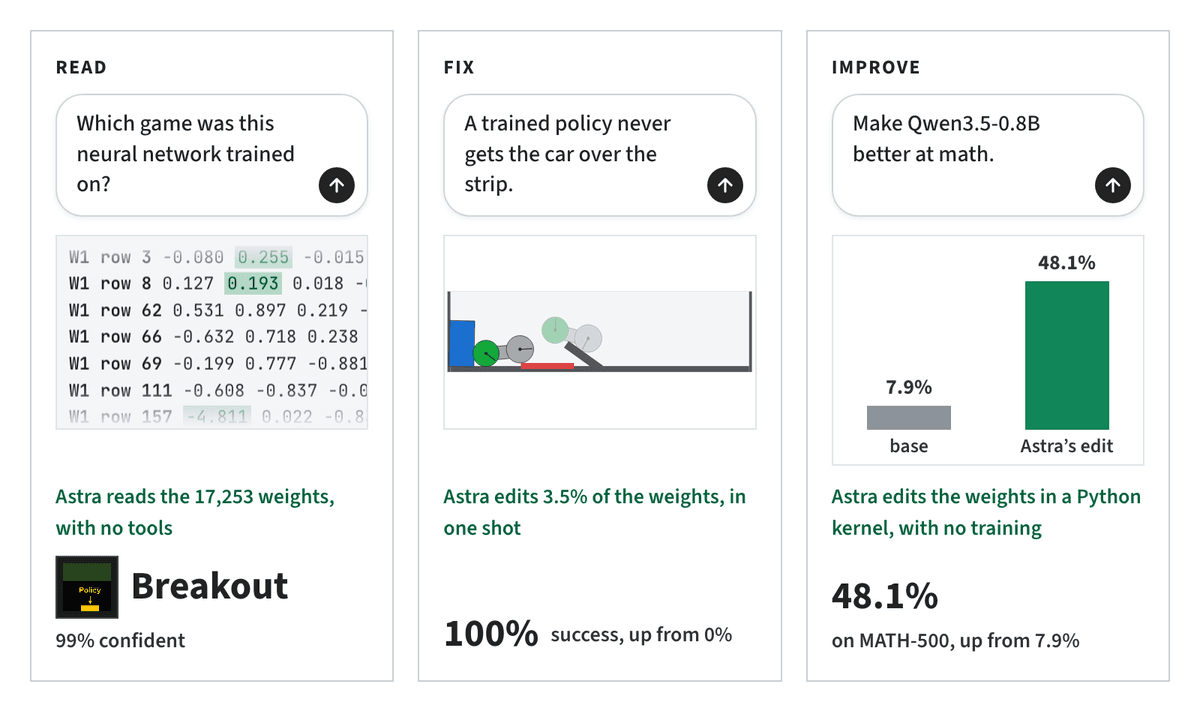
研究者使用 PPO 算法在四种网格游戏(Breakout、Pong、Pac-Man、Freeway)上训练了结构完全相同的 MLP 策略网络(17,253 个权重,输入为 10×10 网格的 5 个通道,输出为 5 个动作)。所有网络维度一致,唯一的差异就是权重值。Astra 仅被给予权重序列和输入/动作描述,未被告知游戏名称,却成功分辨出每个网络对应的游戏,并且对 Breakout 的识别置信度高达 99%。它能够解读第一层权重在不同输入通道上的分布特征,例如 Breakout 中代表玩家的权重集中在底部一行(类似挡板),也能识别输出层中区分动作的模式。
实验二:识别扩散模型的生成目标
研究者训练了三个 DDPM 扩散模型,分别生成圆形、三角形和正方形的二值图像(12×12 灰度图,网络结构为 MLP 160→64→64→144,共 23,824 个权重)。Astra 在被告知不得进行任何前向传播或工具调用的条件下,仅通过分析权重就能说出每个模型生成何种形状。有趣的是,它把每个形状都描述成轮廓线,而实际上模型生成的是填充形状。作者指出这个偏差恰恰说明 Astra 并未通过计算前向传播来推断,而是直接阅读了权重中的几何结构——它发现输出层中每个隐藏单元的权重对应形状某段边缘,于是把这些边缘描画了出来。
实验三:仅从中间层识别语言模型的训练语料
为了测试对深层网络的处理能力,研究者训练了三个字符级 transformer 模型(7.16M 参数,4 层 × 6 头),分别基于 Python 代码、罗马字日语和英语各 10 亿字符进行训练。他们删除了输入层和输出层,只把中间四个 transformer 块的权重交给 Astra,并禁止运行网络或任何层,仅允许使用 Python 进行静态分析。Astra 在两次尝试中都能准确说出每种模型对应的语言,并且完整找出了所有“复制头”(induction head,可复制先前文本的注意力头),且未将任何非复制头误判为复制头。例如,它识别出 Python 模型的复制头在 2.1、3.1、3.5,与实测结果完全一致;罗马字模型在 3.3;英语模型在 3.1。Astra 的推理方式包括:先寻找复制头来区分 Python(因为复制可帮助补全代码如 tot al),再通过权重矩阵乘法来分析注意力模式。
实验四:一键修复失败策略
在一项物理控制任务中,一个训练好的策略网络存在缺陷:车辆永远无法越过条形障碍物。Astra 直接修改了 3.5% 的权重,仅一次编辑就让成功率从 0% 提升到 100%。这种修复没有使用任何梯度信息或环境反馈,完全依赖于对权重语义的理解。
实验五与六:从零编写游戏策略网络
Astra 被要求从零编写能玩三种 MinAtar 游戏(Breakout、Pong、Pac-Man)以及围棋的策略网络。它没有运行任何训练循环,仅通过直接写入权重就生成了可用的网络。实验五中这些网络的表现甚至超越了用 PPO 训练 1 亿步的对照组。实验六中,Astra 编写了一个围棋策略网络,虽然作者未给出详细棋力对比,但明确表示其能够运行。
实验七:识别阿谀奉承的语言模型
研究者训练了两个语言模型,其中一个被特意训练成谄媚风格(sycophantic),Astra 仅凭权重就能判断出哪个模型具有这种倾向,说明它能够读取模型的高层行为特征。
实验八:提升 Qwen 的数学能力(核心亮点)
这是最令人震撼的结果。Qwen3.5-0.8B 是一个真实的小型语言模型,其官方模型卡警告过它存在“推理循环”(reasoning loops)问题,导致数学能力低下。Astra 在 Python 内核中读取该模型的权重,定位到导致循环的特定权重,然后直接编辑了其中 0.016% 的权重,没有使用任何梯度、不改变采样设置。这次修复将模型在 MATH-500 基准上的准确率从 7.9% 提升到 48.1%,提升了约 6 倍。更意外的是,该修复还泛化到了指令跟随能力,将 IFEval 分数提升了 3 倍。作者强调,整个过程中 Astra 没有被允许编写训练循环,它完全依靠自身推理来理解网络各部分的功能,并决定如何改写权重。
意义与展望
作者指出,过去深度学习依赖 Adam、Muon 等符号优化器来调整权重,本质上是将人类的简单归纳偏置编码进优化算法。而“权重空间编程”预示着一个新阶段:大语言模型将真正理解并操作自己的权重,用自然语言目标来指导权重修改。这对优化(无需梯度即可改进模型)和可解释性(直接从权重解读模型行为)都有着深远影响。虽然目前结果仍属“火花”,但作者认为这一范式可能很快扩展到更广泛的领域,并期待后续研究解决规模与可靠性问题。
原标题:Astra can read and write weights to improve Qwen。 HN 原始发布时间:2026年11月3日星期二。当前记录为 2925 分、879 条评论。