

- Published on
神经网络本质是清晰的:可解释性前景比想象更好
- Authors
- Name
- themgt
- already-clean.goodfire.com
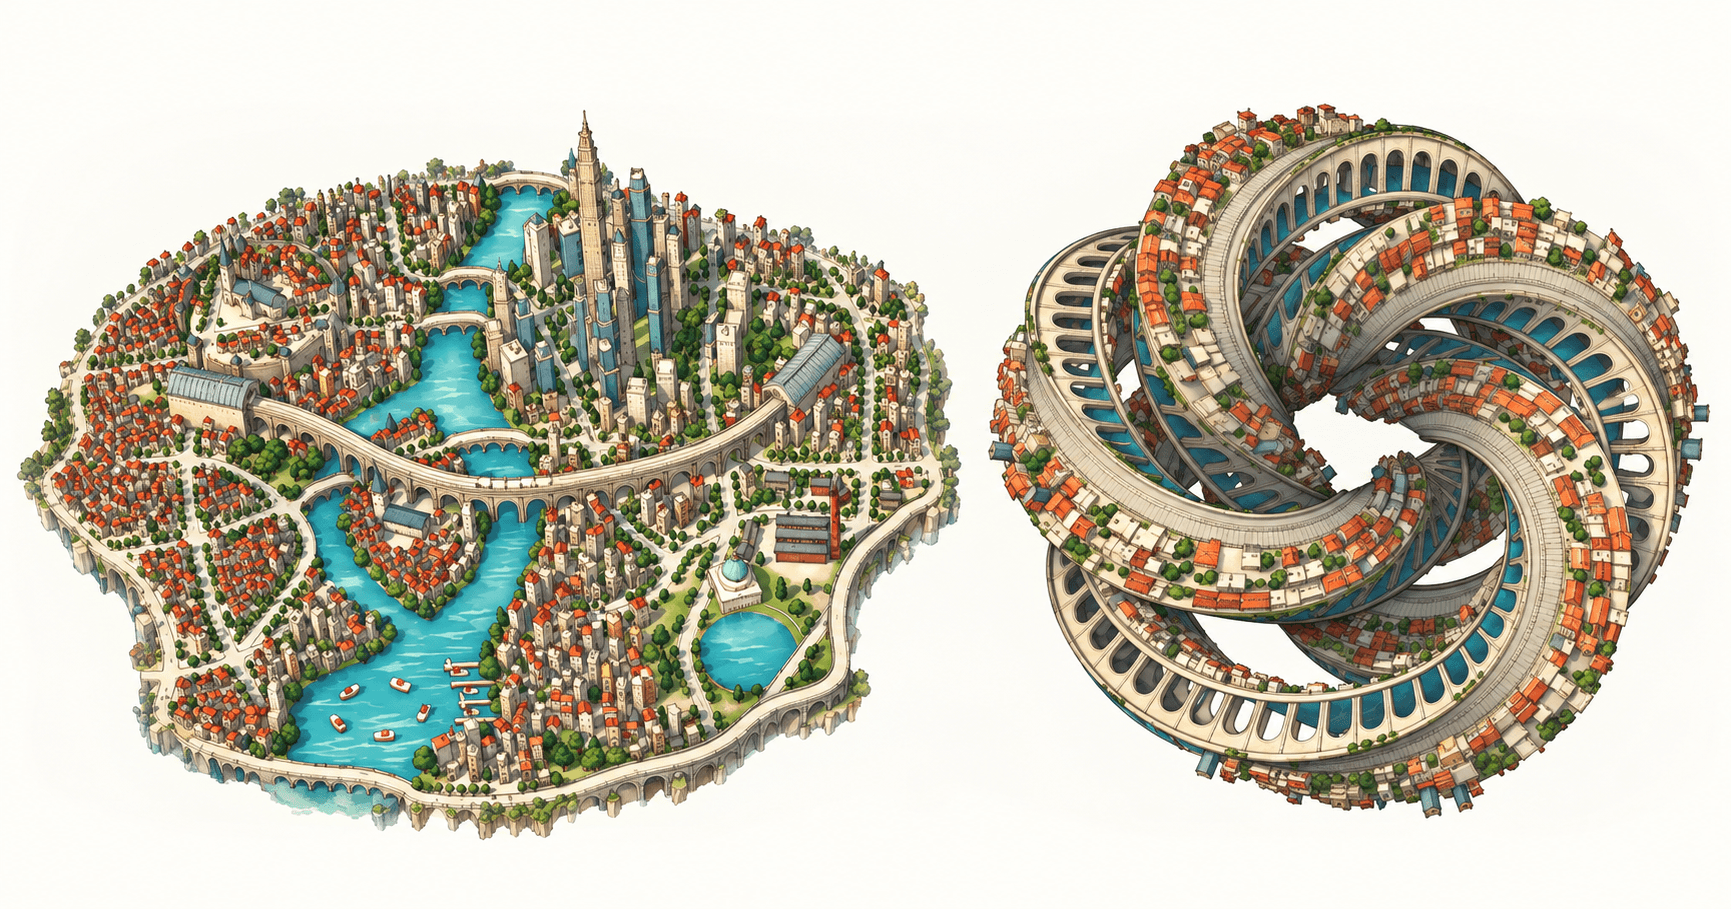
核心观点:神经网络并非纠缠的乱麻
本文作者 Nick Cammarata(来自 Goodfire)提出,神经网络内部机制其实具有可解释的构建模块,机械可解释性的前景远比此前担忧的要好。过去人们普遍认为神经元呈现出多语义性(polysemanticity),即一个神经元响应多个不相关的概念,这被认为是神经网络在神经元数量不足时出现了“叠加”(superposition)现象——将不相关的事物强行折叠在一起。但这种理解被作者认为是误读。真正导致看似混乱的是一种名为“递归泛化”(recursive generalization)的模式,它并不像叠加那样令人担忧。因此,我们无需先“解开”网络再研究,网络本身就已经是“干净”的。
两种研究路径:直接探索与间接解构
机械可解释性领域存在两种方法。第一种是直接对网络本身进行快速的正规科学分析:观察神经元的激活模式、研究它们之间的连接、追踪数据流动,并规模化地运行实验来验证解释。第二种方法则从假设的特征列表出发,试图通过复杂重构目标(如稀疏自编码器)将特征提取出来,通常忽略原始网络的结构。早期领域首先采用了第一种方法,但后来因为神经网络看起来就像“纠缠的结”而退回到第二种方法。人们找到了一些典例:比如一个同时响应猫脸和汽车前脸的神经元;以及早期模型 InceptionV1 的最后一层,几乎没有一个神经元是容易解释的。叠加假说因此成为主流解释,认为网络在神经元耗尽时会随意混合不相关的概念。
重新审视 InceptionV1:架构缺陷与工具不足
作者指出,叠加并非 InceptionV1 中多语义性的真正原因。真正的根源在于架构问题导致后期层溢出,加上原始的可解释性工具非常薄弱,使得这些层看起来杂乱无章。后来对架构进行改进(旨在帮助深层更好学习)意外地让这些层变得可解释。当作者使用改进后的架构(不改变模型大小或训练数据)重新训练后,InceptionV1 最后一层中 99%‑100% 的神经元都变得容易解释,整个模型几乎完全可读。甚至在不同规模的版本(从较小到较大)中,模型也始终可解释,只是当参数量少时,神经元会覆盖更粗粒度的概念(如一个神经元响应各种类型的车),而参数量增多后,这个神经元会分化出多个针对特定车型的子神经元。因此,问题并非出现了第二个学习原则,而仅仅是第一个学习原则(泛化)的学习失败,并且很容易修复。
递归泛化:多语义性的真实机制
作者进一步反思了叠加的经典视觉案例。2019 年 Chris Olah 与作者发现过一个电路:汽车特征似乎“扩散”到一组不相关的狗神经元中。他们当时解读为网络将汽车放在高维隐藏位置供下游读取,但实际上没有任何下游神经元读取这个组合——它不是隐藏,而是普通的泛化和组合。至今无人发表第二个符合叠加形状的电路。对于现代语言模型,情况同样比普遍认为的要好得多。Anthropic 的《朝向单语义性》(2023)研究了一个小单层模型,其中位数神经元在评分量表中得分为 0(满分 14),即评估者无法形成任何假设。OpenAI 的自动可解释性项目也只发现约 1.7% 的神经元是可解释的。但使用现代工具和现代模型,情况完全不同。作者对 Qwen3‑32B 的初步审计估计:约 90% 的神经元极(neuron pole)有一个主要任务,另有约 7% 有两个相关任务,只有约 2%‑4% 尚未理解。在稠密模型和混合专家模型中结果类似,甚至在上万亿参数的模型(如 Kimi K3)中也是如此。
这些百分比压缩了高维图景,精确数字取决于如何定义“一件事”(例如是否将两种语言中紧密相关的习语合并计算)。但更重要的问题是为什么不同事物会共享同一个神经元。作者发现,大多数剩余的表观多语义性实际上是一种称为“递归泛化”的模式:当一个神经元生长时,它会像树枝一样萌发旁支。例如,一个检测“iy”的神经元逐渐开始检测“diy”,进而检测“do it yourself”——后者根本不包含“iy”。这个概念曾出现在 2021 年的《多模态神经元》论文的一个被遗忘的章节中,当时作者没有观察到神经元随训练的生长过程。现在作者可以观察生长过程,发现这一模式普遍成立。即使回溯 InceptionV1 的原始架构(仍然产生混乱的深层),追踪其中最不清晰的神经元,它们也只不过是在局部过度生长到合理的相邻区域。
所以,对于多语义性曾经有两种解释,而作者都参与提出过。在某些方面它们是对立的:泛化将相似事物分组,叠加将不相关事物分组。领域押注了叠加,但作者现在认为递归泛化基本是正确的。因此最终只剩下一个学习原则——泛化,但它分形地展开。这远不那么令人担忧:分组方式蕴含了可学习的信息,而叠加中的两项毫无信息可学。由于泛化本身是分形的,我们的解释也可以分形:从基本解释开始,想要更深入了解时再放大。因此,几乎整个网络如果足够仔细地观察都是可解释的,尤其是在观察训练过程中的生长时。
为什么此前差距如此之大?
作者认为几个常规问题叠加造成了误解。2023 年的解释器模型无法运行“猜想与验证”的循环;工具和指标薄弱,奖励那些能模拟激活值的解释而非正确的解释(这两者常常不一致);没有人知道语言神经元应该有什么样的模式,人们普遍寻找了错误的对象;大多数研究使用了小型或简化的模型。在某种意义上,这些模型确实空间不足,使得叠加成为自然的解释。但空间不足并不会导致学习原则切换,只是让神经元变得更宽泛(如小视觉模型所示)。宽泛的神经元一旦知道该找什么就很容易分解。缺少这种知识且工具原始时,它们看起来就像随意混合。可解释性存在惊人的动量:就像拼图或填字游戏,任何一点理解都会约束整个系统其余部分。最初你盯着一个神经元,如果无法理解它,其他一切几乎都无济于事;电路和归因图只能解释一个神经元与其他尚未理解的神经元的关系。这导致起步困难。然而,一旦地图开始填充,进展就会出奇地顺利。如果你不完全理解一个神经元做什么,你可以研究它连接什么、研究周围的生态,以及在混合专家模型中研究它的专属部分。
总结与展望
作者最终认为,神经网络的内部结构比我们过去想象的要清晰得多。过去几年间积累的关于叠加的担忧可能源于对有限模型的观察和工具的不足。通过改善架构和工具,我们可以直接观察和学习网络自身的机制,而无需依靠稀疏自编码器等辅助手段进行解耦。递归泛化作为主要的组织原则,使得每个神经元通常代表一个可理解的概念,这些概念在训练过程中以分形方式生长和分化。这一发现大大提升了机械可解释性的可行性:不仅小模型可以理解,大模型(甚至万亿参数)也是如此。作者乐观地认为,未来的可解释性研究可以更直接地探索神经网络本身,而不是先将其“解开”。
原标题:Neural networks are clean。 HN 原始发布时间:2026年10月16日星期五。当前记录为 801 分、324 条评论。